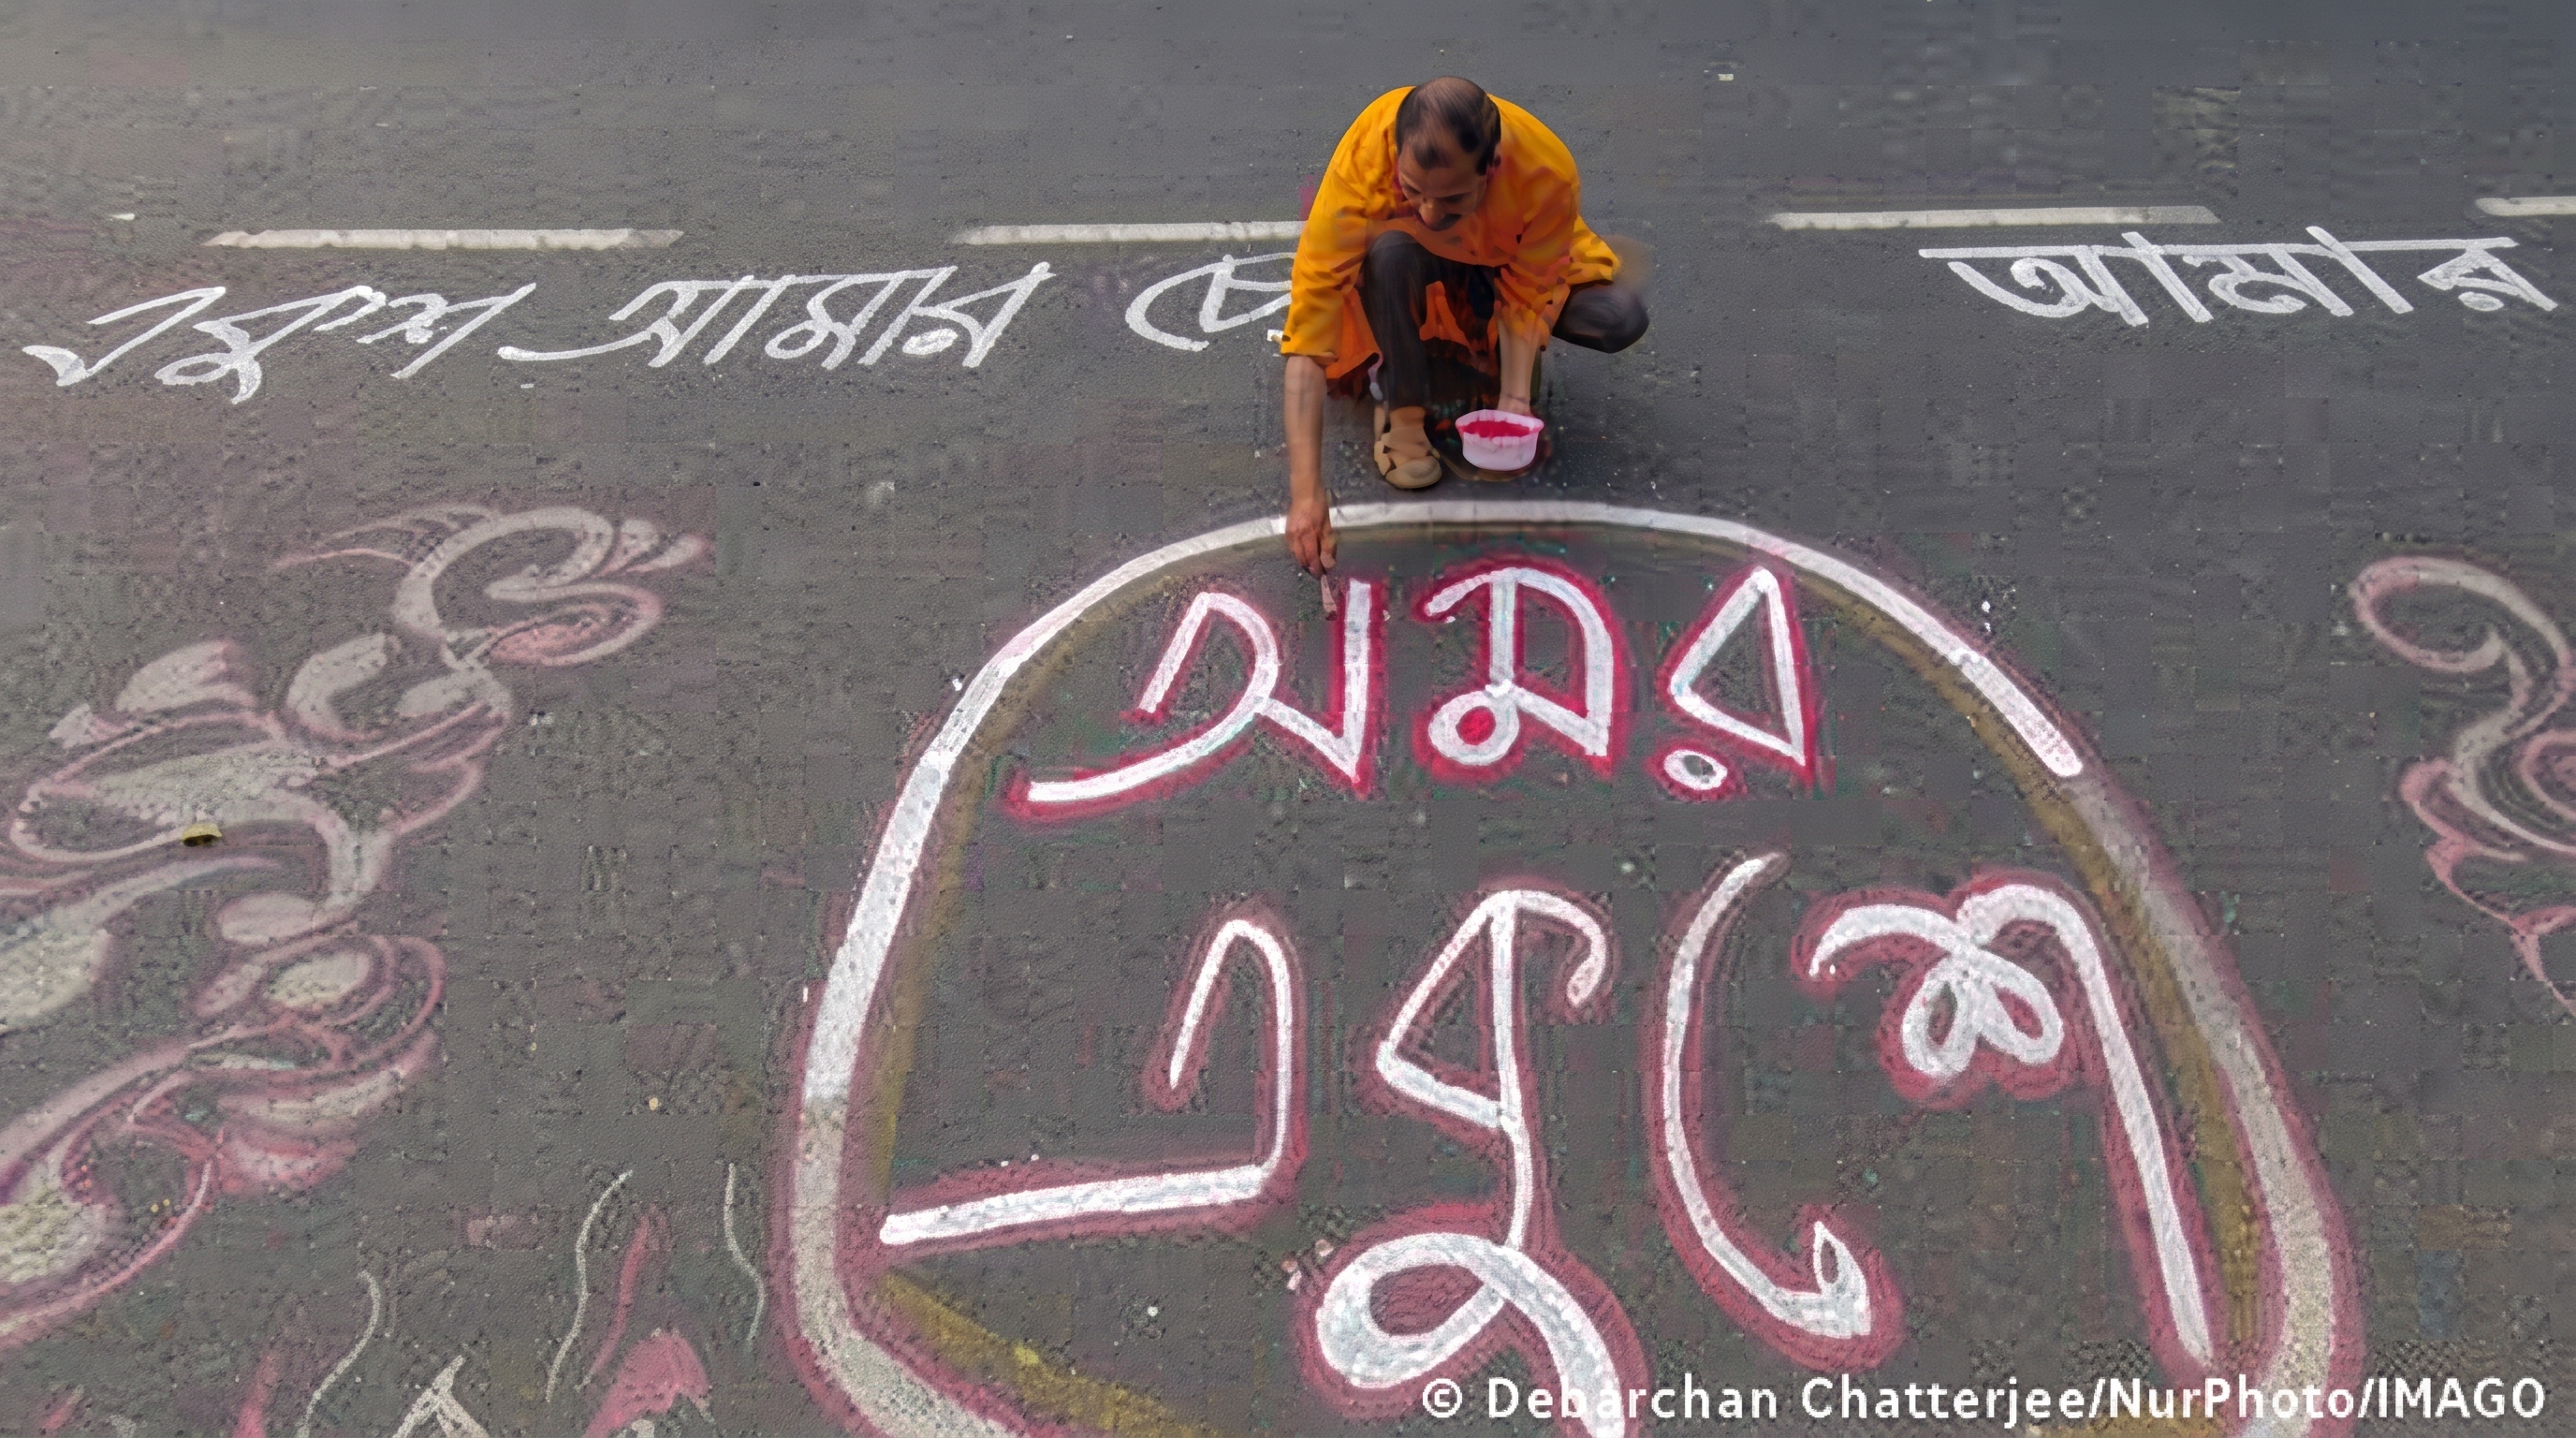
Indiens Sprachvielfalt und KI: Wer entscheidet, welche Sprachen digital sichtbar werden
Indien verfügt über eine außerordentliche Sprachenvielfalt — Hunderte von Sprachen, die von Millionen Menschen gesprochen werden. Doch während künstliche Intelligenz die Kommunikation neu gestaltet, stehen die meisten dieser Sprachen vor einer grundlegenden Herausforderung: Es fehlt ihnen an digitalen Daten, die KI zum Erlernen dieser Sprachen benötigt.
Das Datenproblem
Große Sprachmodelle werden überwiegend mit Texten aus dem Internet trainiert, das von Englisch, Mandarin und einer Handvoll anderer Großsprachen dominiert wird. Für Indiens kleinere Sprachen — viele mit reicher Literaturtradition, aber begrenzter Online-Präsenz — entsteht so eine Sichtbarkeitslücke.
KI als möglicher Ausgleicher
Einige Forscher sehen eine Chance: Durch das Erstellen von Datensätzen für unterrepräsentierte indische Sprachen und das Training spezialisierter Modelle könnte KI zu einem Werkzeug für Spracherhaltung werden. Kritiker warnen aber, dass die Macht über die Ressourcenverteilung weitgehend bei großen Technologieunternehmen liegt.

Wir verwenden Cookies, um Ihre Erfahrung zu verbessern. Datenschutzrichtlinie