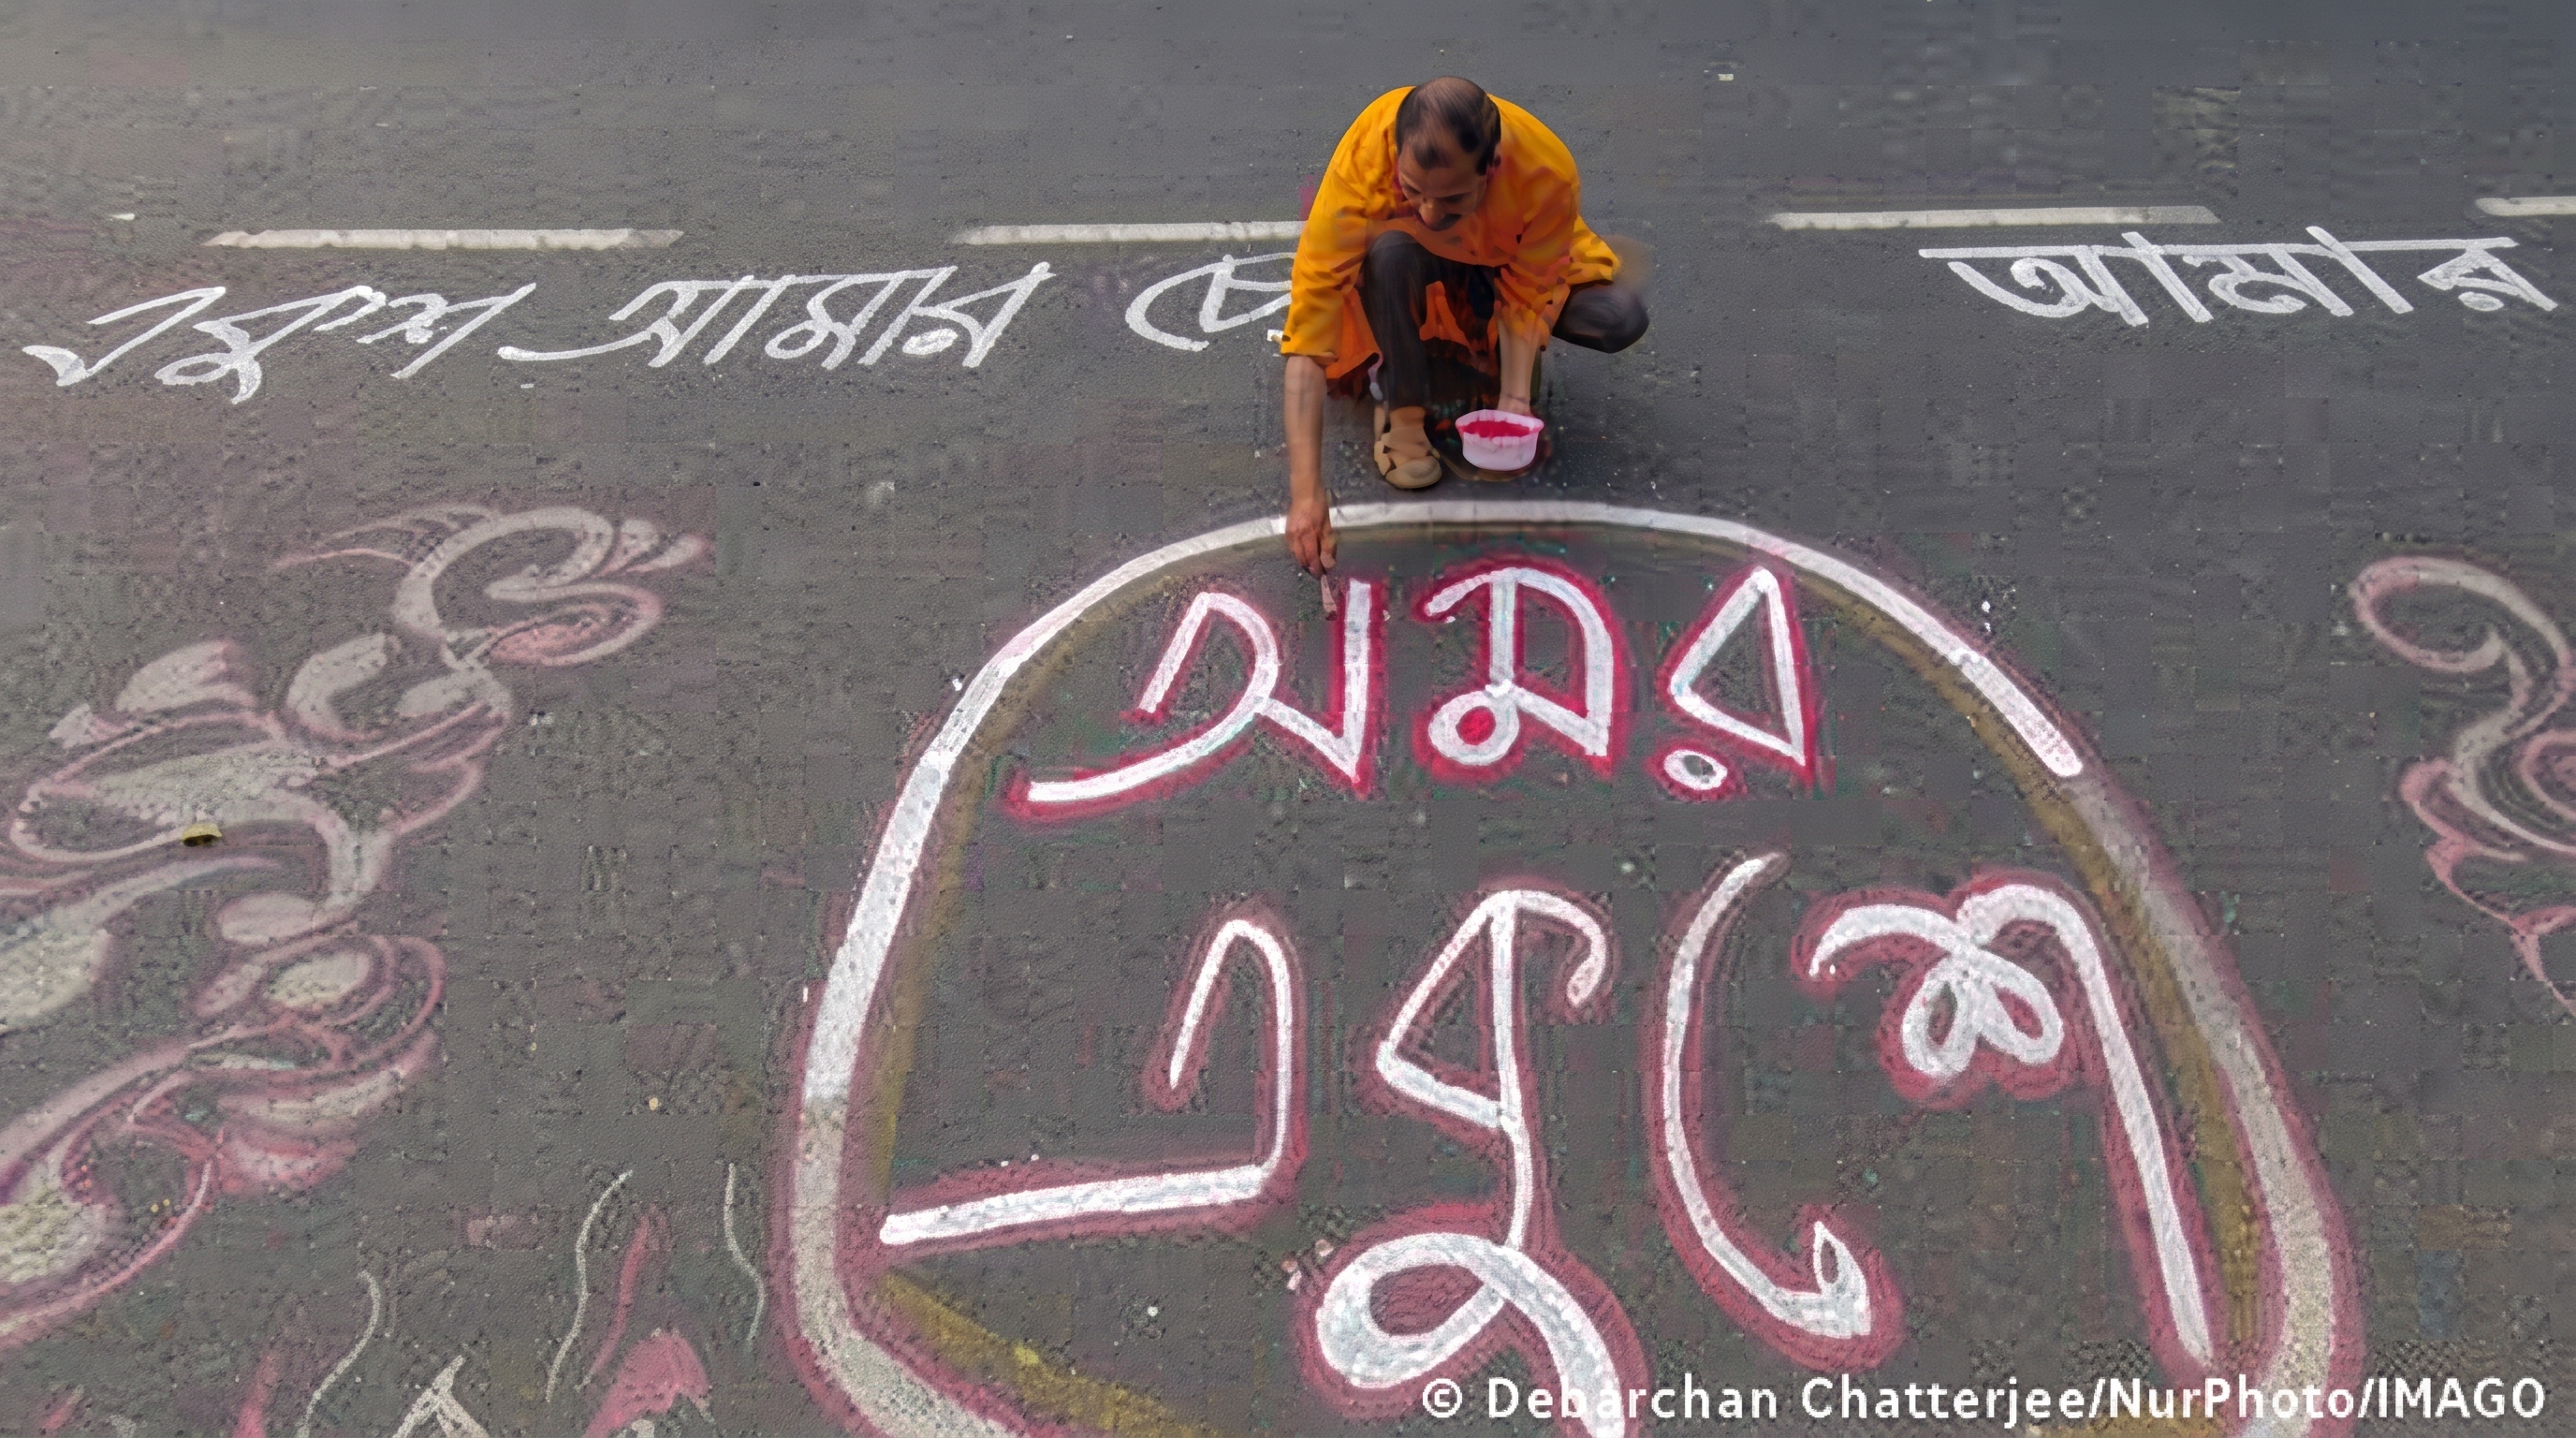
La diversité linguistique de l'Inde et l'IA : qui décide quelles langues entrent dans l'ère numérique
L'Inde possède une diversité linguistique exceptionnelle — des centaines de langues parlées par des millions de personnes. Pourtant, à mesure que l'intelligence artificielle transforme la communication, la plupart de ces langues font face à un défi fondamental : elles manquent des données numériques dont l'IA a besoin pour les apprendre.
Le problème des données
Les grands modèles de langage sont principalement entraînés sur des textes d'internet, dominés par l'anglais, le mandarin et quelques autres grandes langues. Pour les langues minoritaires d'Inde, cela crée un fossé de visibilité.
L'IA comme potentiel égalisateur
Certains chercheurs voient une opportunité : en créant des jeux de données pour les langues indiennes sous-représentées, l'IA pourrait devenir un outil de préservation linguistique. Mais les critiques avertissent que la décision sur les investissements appartient largement aux grandes entreprises technologiques.

Nous utilisons des cookies pour améliorer votre expérience. Politique de confidentialité